WebエンジニアがGemini API×ESP32で「音声指示で動く自律走行ロボット」を作ってみた【AI連携・自律走行編】
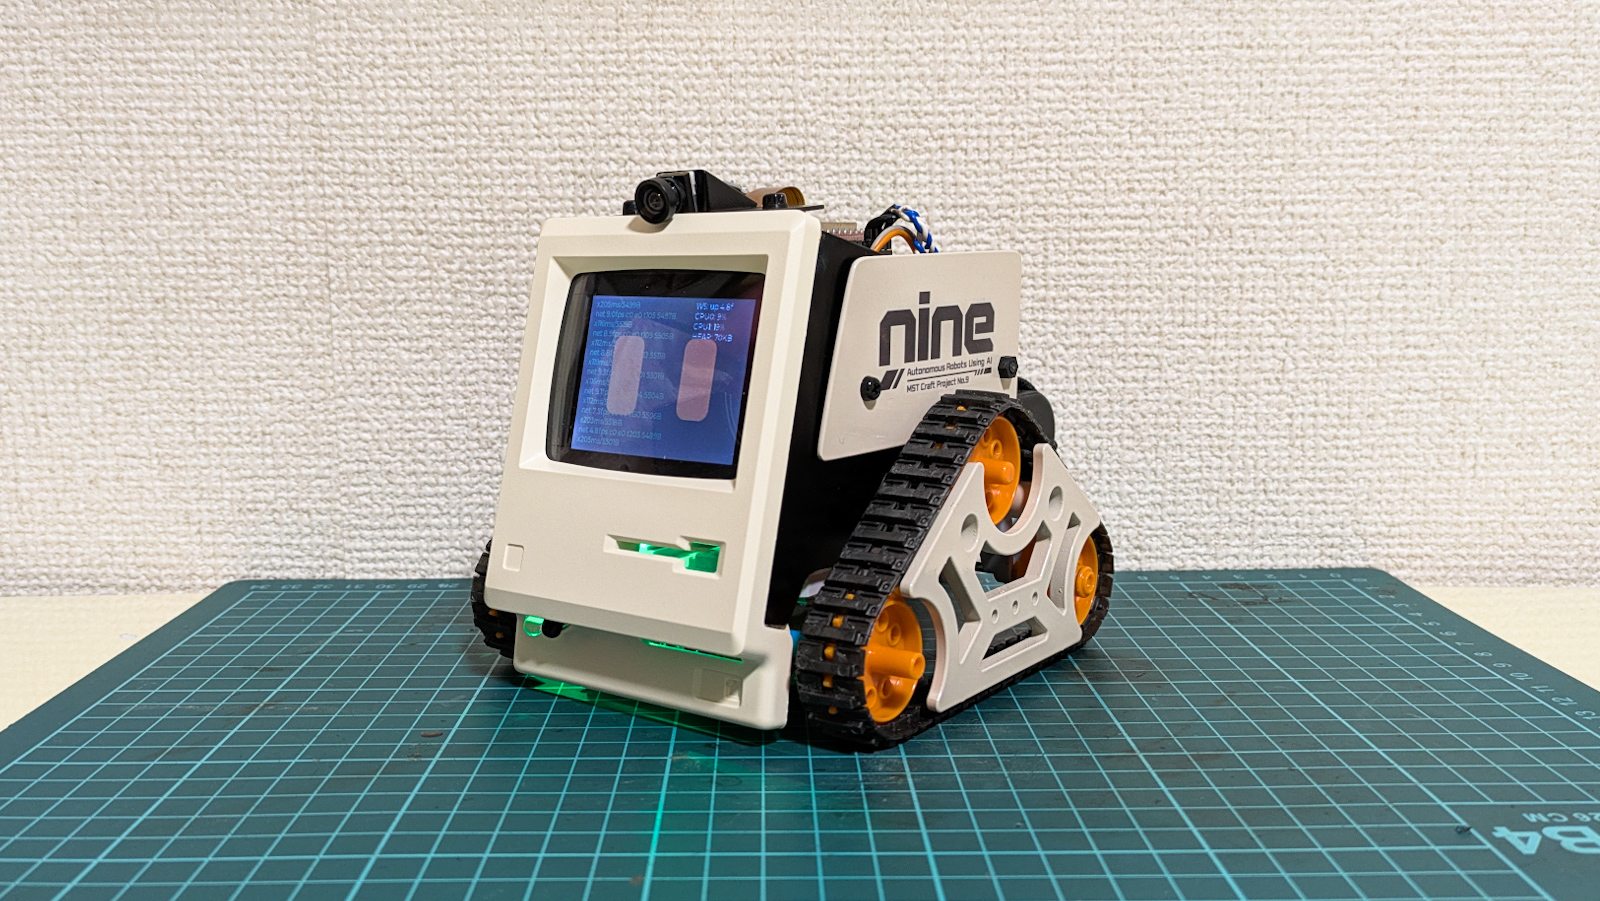
音声で「赤い缶に近づいて」と指示すると、障害物を自律的に回避しながら目標へ移動する小型ロボットの制作に挑戦します。
今回は第3回「AI連携・自律走行編」です。
第2回の記事はWebエンジニアがGemini API×ESP32で「音声指示で動く自律走行ロボット」を作ってみた【機体と回路の構築編】になります。
自律走行システムの構成方針
前回の制作を終えた時点では、Webブラウザの操作盤を介して人間が操縦する状態にとどまっており、操作の反映に遅延があるFPV(一人称視点)ラジコンにすぎませんでした。
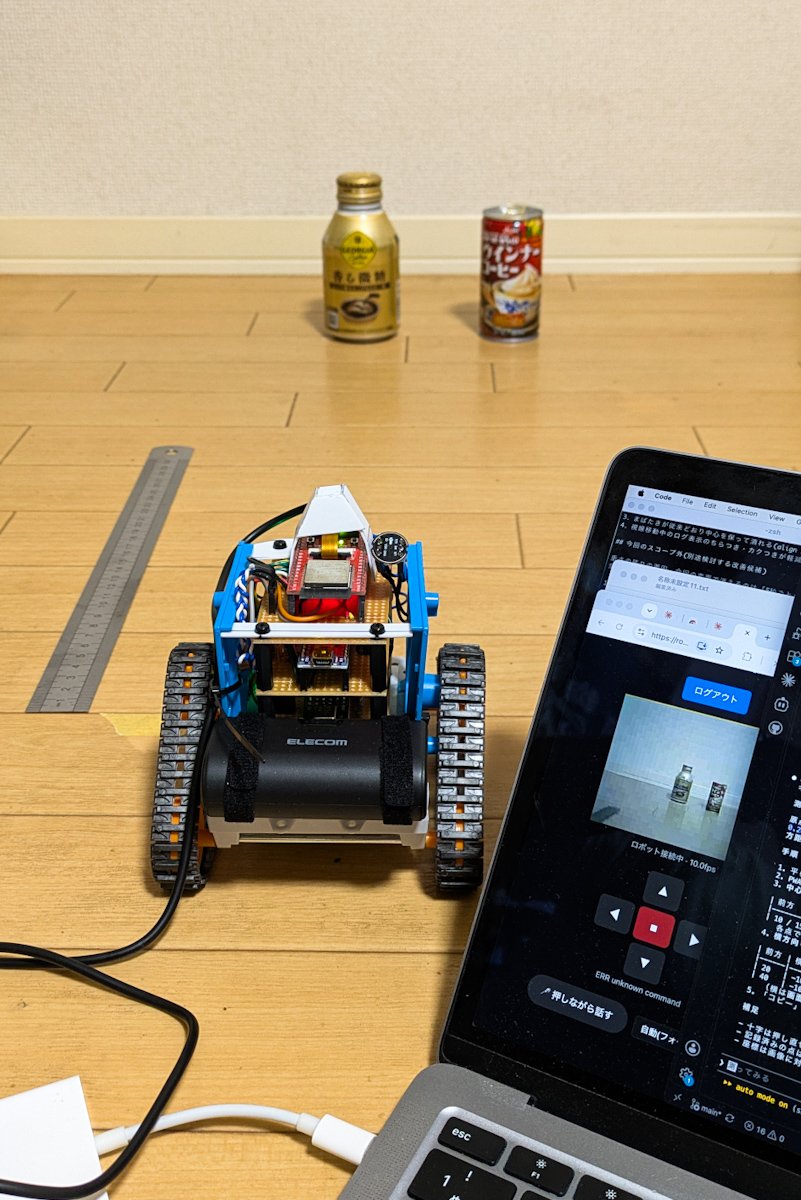
当初の構想では、機体に搭載したESP32で直接音声を受け取り、音声認識APIへ送信して文字起こしを行う計画でした。さらにテキスト化された命令とカメラ画像をマルチモーダル推論APIへ送信し、経路の選定と機体の制御コマンド群を受け取るという流れを想定していました。
しかし、すべての処理を機体上のマイコンへ一度に実装するのは検証の手間が大きくなります。そこで、段階的に動作を確認しやすい環境から構築する方針を採りました。Cloudflare上に構築済みのWeb操作盤を中継点とし、次の機能を順に追加していきます。
- 音声入力にはスマートフォンやPCのマイク機能を利用する
- 取得した音声を音声認識APIへ送信して文字起こしを行う
- Web操作盤に届いているカメラ画像と文字起こし結果をマルチモーダル推論APIへ送信する
処理をWeb側に集約することで、デバッグが容易になり、マイコン側のメモリや処理能力の不足に直面する事態も回避できます。今回の主目的はAIによる自律走行の検証にあるため、音声入力の取得は端末側の機能を活用する構成に決めました。
処理フローの全体像
全体の処理フローは次のとおりです。
- 人間が端末に向かって「赤い缶に近づいて」と発話する
- 音声認識APIの文字起こし処理により、音声を「赤い缶に近づいて」というテキストへ変換する
- 機体のカメラが捉えた画像にテキスト命令を添えて、マルチモーダルモデルへ送信する
- 推論APIが対象物体を認識し、回避ルートの計算と機体の移動コマンド群を生成する
- 機体が受信したコマンドを順次実行する
以降の挙動については、実機を走行させながら調整を進めます。1枚の画像から「前進・右旋回・前進」のように数手先までの移動コマンドをまとめて生成して賄えるか、あるいは1手ごとに画像を再取得してAIへ判定を委ねる堅実な構成にするかを検証していきます。
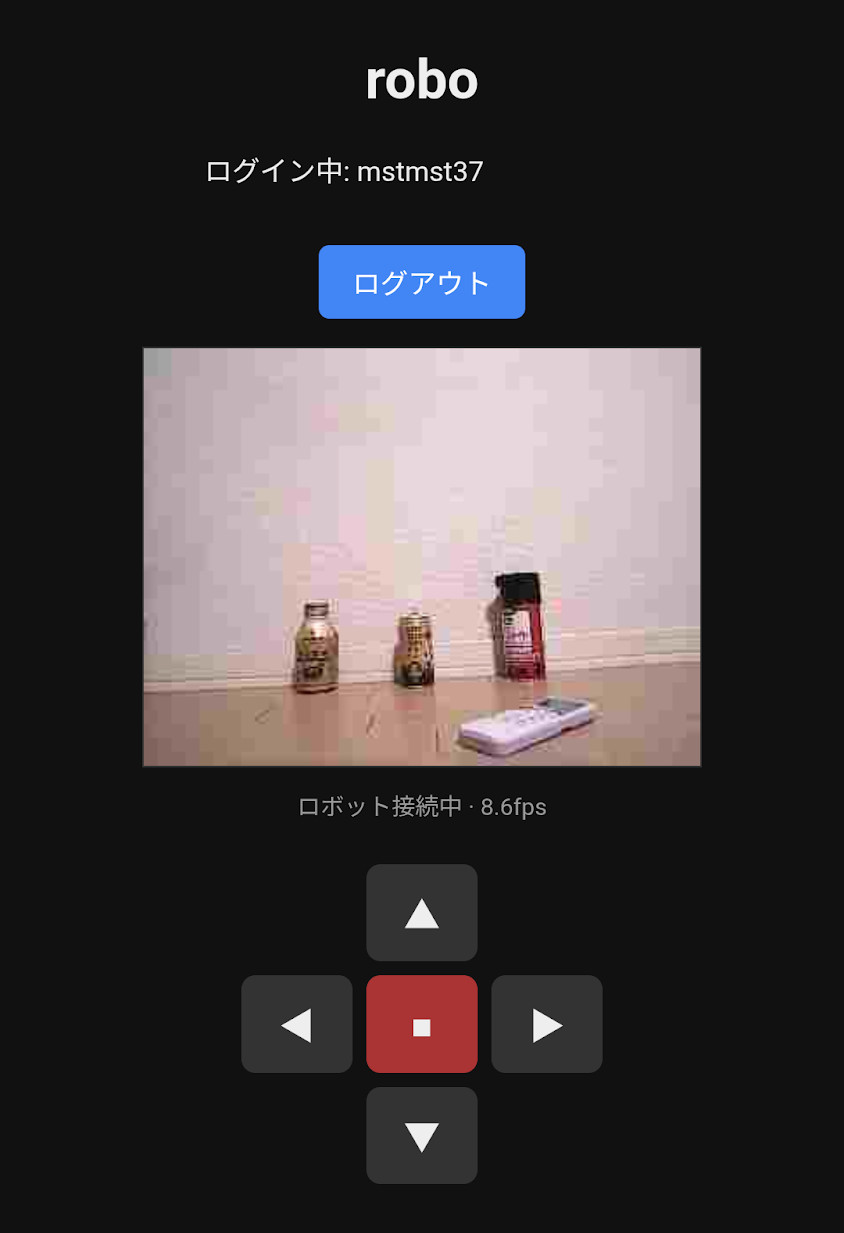
Geminiを用いた音声認識とテキスト化
音声の文字起こしにはGemini 3.5 Transcribeを採用しました。Web操作盤にはボタンを押している間だけ音声入力を受け付けるUIを追加し、入力が完了した段階で音声データをAPIへ送信します。返却された「赤い缶に近づいて」というテキストを次の処理へ渡します。
無料利用枠で開発を進める際、試行回数が増えるとレート制限に達しやすいため、より軽量なモデルへのフォールバック処理を組み込んでおくと、制限を気にせず検証を継続できます。
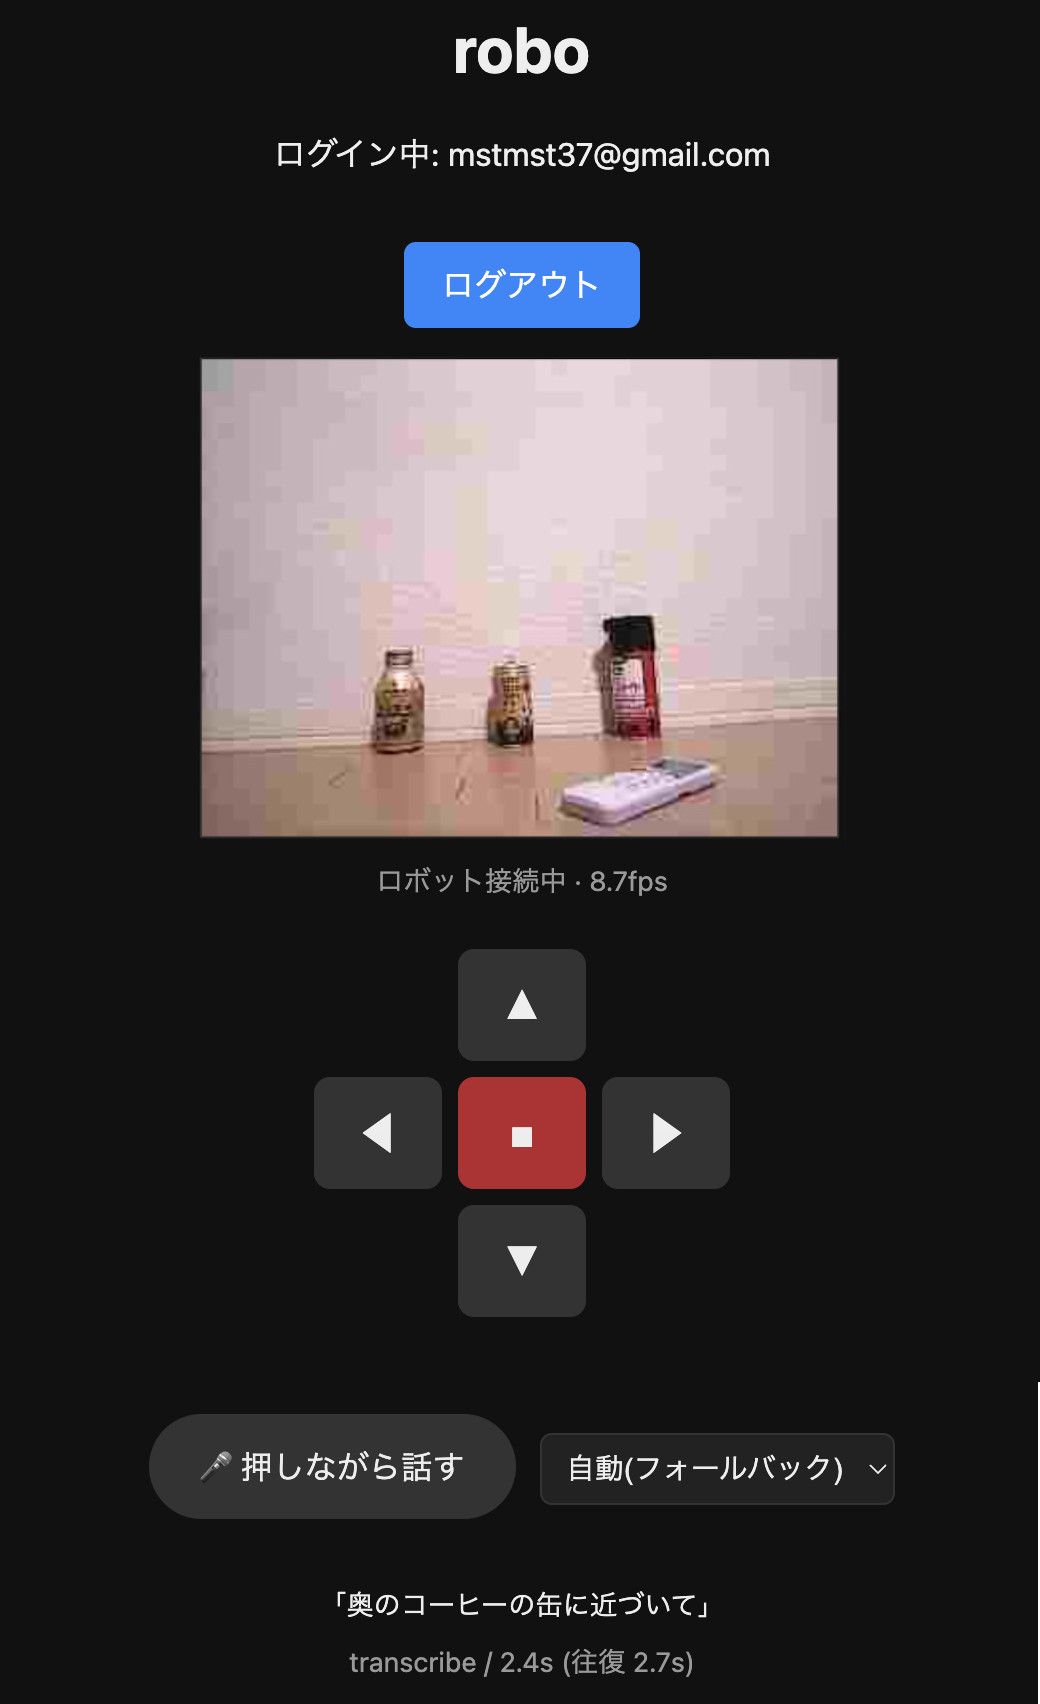
マルチモーダルモデルによる物体検出と走破性判定
Web操作盤側では機体の現在位置からの視界をJPEG形式で保持しています。この画像データに、先ほど文字起こしした「赤い缶に近づいて」という指示を添えてGemini 3.6 Flashへ送信します。
プロンプトでは、機体を目的地へ誘導するために必要な情報を指定します。
- 指示内容(テキスト化した「赤い缶に近づいて」)の受け渡し
- 視界内に存在する物体のバウンディングボックス(
box_2d)による特定(目標物、回避すべき障害物、それぞれの大きさ) - 障害物の高さに応じた走破可能性の判定
function perceivePrompt(instruction) {
  return [
    "あなたは床を走る小型ロボットの目です。画像はロボットの前方を写したものです。",
    `ロボットへの指示は「${instruction}」です。`,
    "",
    "1. 指示の対象と思われる物を1つだけ選び、targetに入れてください。",
    "   labelには選んだ物を具体的に書いてください(例:「マグカップ」)。",
    "   指示の対象が画像内に見当たらない場合はfound=falseにし、box_2dは空配列にしてください。",
    "2. 床の上にあってロボットの進路の妨げになりうる物をobstaclesに挙げてください。",
    "   targetそのものはobstaclesに含めないでください。",
    "   traversableは、車高の低いクローラー車が乗り越えられる高さかどうかです。",
    "   薄いケーブルや紙は乗り越えられ、リモコンや箱のような高さのある物は乗り越えられません。",
    "3. noteには、指示の解釈に迷った点や、想定外の状況(対象が複数ある、",
    "   手前が塞がっているなど)があれば短く日本語で書いてください。無ければ空文字。",
    "",
    "box_2dは [ymin, xmin, ymax, xmax] を0-1000に正規化した整数で返してください。",
  ].join("\n");
}自律走行の動作自体には直接関与しませんが、認識状況を人間が確認できるよう、Web操作盤のカメラ画像上へ取得したbox_2dの矩形枠を描画する機能も実装しました。
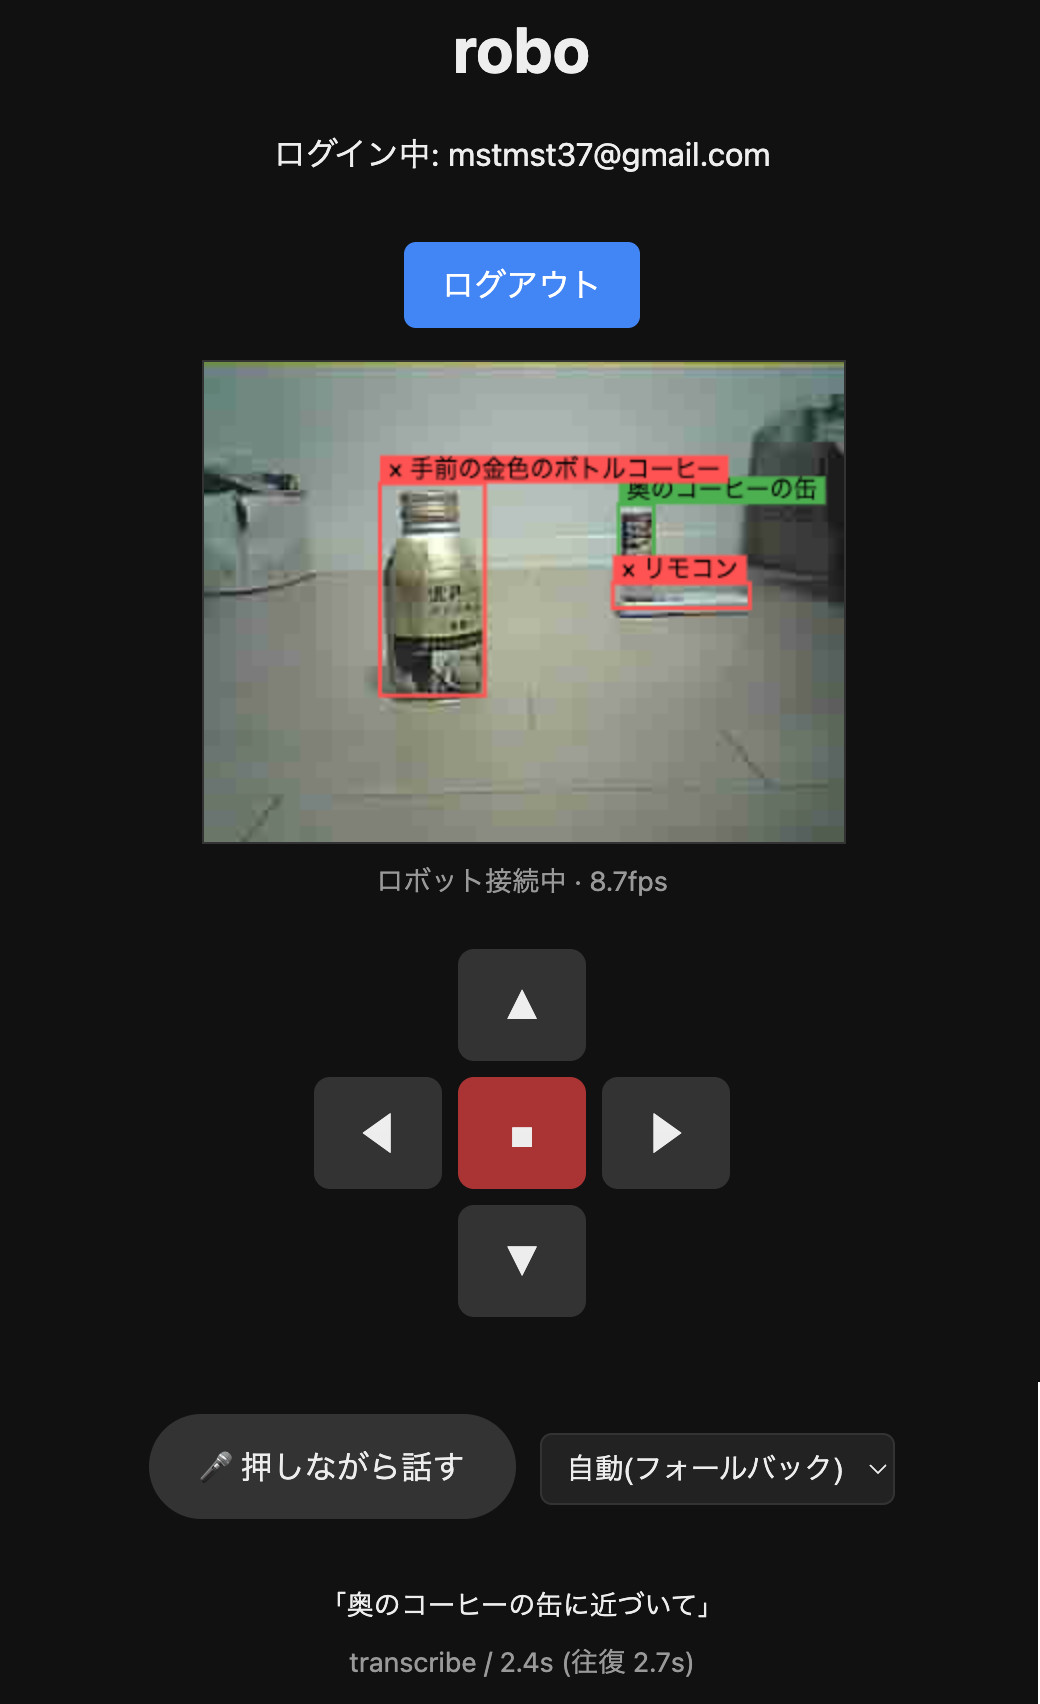
試行錯誤
当初は「前進・後退・右旋回・左旋回」といった具体的な移動量(例: curve(0, 30)で右へ30度旋回)の算出までをAIの返答に委ねていました。
しかし、この方式では安定した走行ができませんでした。単眼カメラの画像では、遠くにある物体ほど距離の推定誤差が大きくなり、カメラの取り付け位置や画角のわずかな変化でも計算が狂ってしまうためです。補正用のパラメータをプロンプトへ随時追加する方法も検討できますが、プロンプトの肥大化に伴い応答速度が低下します。
試行を重ねた結果、モデルが担当する領域を「何がどこに見えるか」という物体認識までに限定しました。カメラの設置高と仰角を固定し、検出枠下端の接地座標から三角測量によって距離を算出する幾何学的な補正計算、障害物との相対位置の判定、そして実際の移動コマンドの生成は、すべてCloudflare側のプログラムコードで処理する構成へ改めました。
Geminiのモデル変更による検出枠座標の安定化
画像認識の検証を進める中で、推論精度の向上を図るためにモデルをGemini Robotics ER 2 Previewへ切り替えて精度を比較しました。
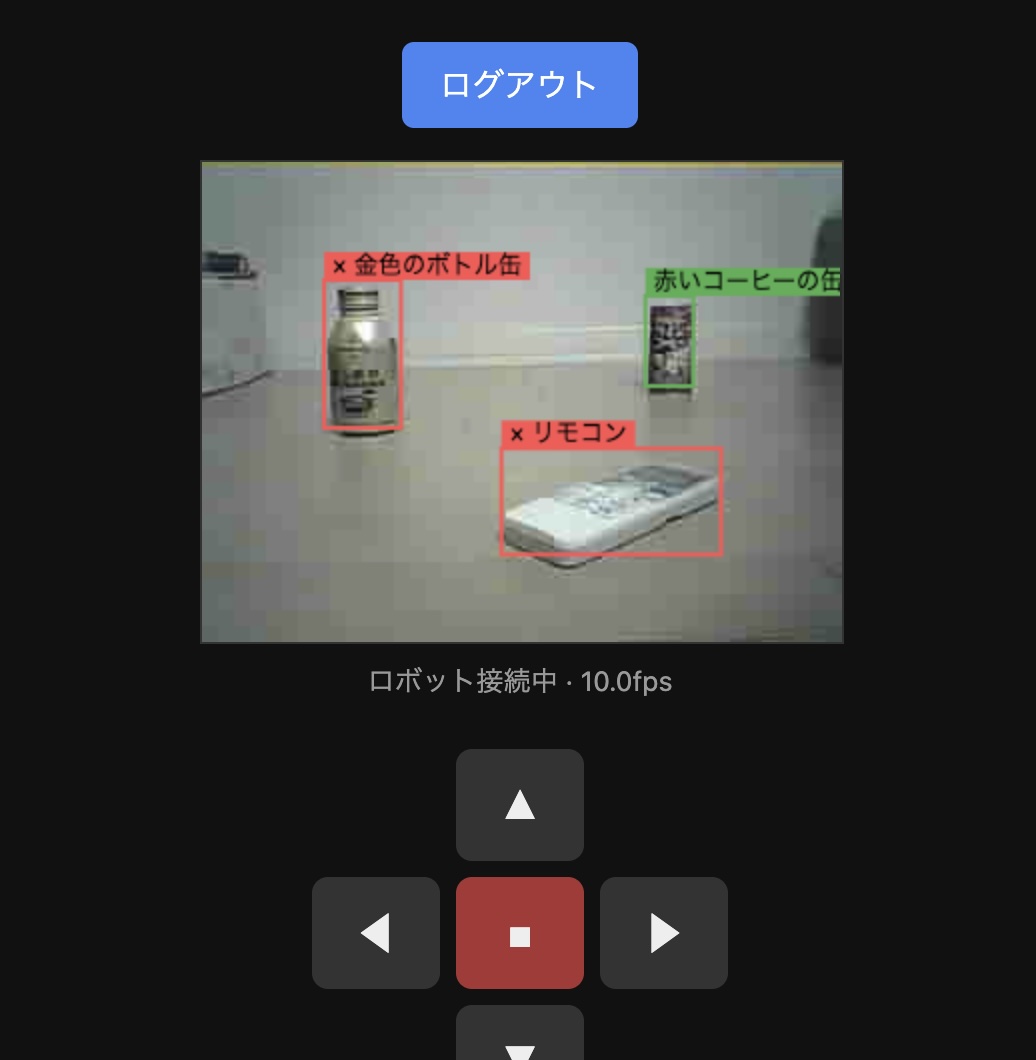
検証の結果、認識精度に明確な差が現れました。Gemini 3.6 Flashでは検出枠(box_2d)の底辺の座標がリクエストごとに上下に変動していたのに対し、Gemini Robotics ER 2 Previewでは枠の位置が安定し、座標のぶれが大幅に減少しました。接地点の座標の安定性は、三角測量に基づく距離推定の精度に直結します。
もっとも、動作ごとに外部APIとの往復通信が発生するため、障害物を回避して目標の缶コーヒーへ到達するまでには相応の待機時間を要します。
応答速度に課題は残るものの、音声指示を起点として、認識結果に基づき障害物を自律的に回避しながら目標へ到達する一連の動作が確認できました。
改善の模索
動作速度の改善に加え、Gemini以外のモデルを適用した際の挙動の違いなど、検証したい項目はまだ残されています。
そこで、機体の基本動作コマンドをModel Context Protocol(MCP)のツールとして定義し、Claudeから機体を直接操作できる構成を実験しました。
機体が解釈できる基本コマンドは次のとおりです。
curve(1000,0):1秒間の前進curve(-1000,0):1秒間の後退curve(0,30):右へ30度の旋回curve(0,-30):左へ30度の旋回beep {OK | NG | WAIT}:ブザー音の出力(判別のために3種類のパターンを用意)snap:静止画の取得stop:停止コマンド
Cloudflare Workers上に機体操作のAPIが構築されていたため、そのAPIを呼び出すMCPサーバーを実装してClaude Desktopと接続しました。
const TOOLS = [
  {
    name: "move_forward",
    description: `前進する(最大${MAX_MOVE_CM}cm)。結果としてArduinoの応答行(status=completed/中断など)を返す。`,
    inputSchema: {
      type: "object",
      properties: { cm: { type: "number", minimum: 1, maximum: MAX_MOVE_CM, description: "進む距離(cm)" } },
      required: ["cm"],
    },
  },
・・・モデル側から扱いやすいよう、移動指示は「何cm前進するか」という実世界の距離で指定できるように設計しています。ツールの内部処理で、距離を「前進1.2秒」に相当するcurve(1200, 0);といった実機コマンドへ変換します。機体の重量、モーターの出力特性、ギアの摩擦抵抗などを実測し、「1.2秒の駆動で約10cm前進する」という補正係数を中継レイヤーで吸収させています。
MCPによる自律探索制御の実装
従来の構成では、人間が操作盤から指示を出すたびに外部APIを都度呼び出す「人間起点」の設計でした。これに対し、MCP経由でツール群を渡す構成にすると、モデル側が必要なタイミングで周囲の状況を確認し、移動を実行する「AI起点」の制御ループへ移行できます。
実験として、Claudeに接続した状態で「自由に動いてみてください」と大まかなプロンプトを与えて動作を観察しました。
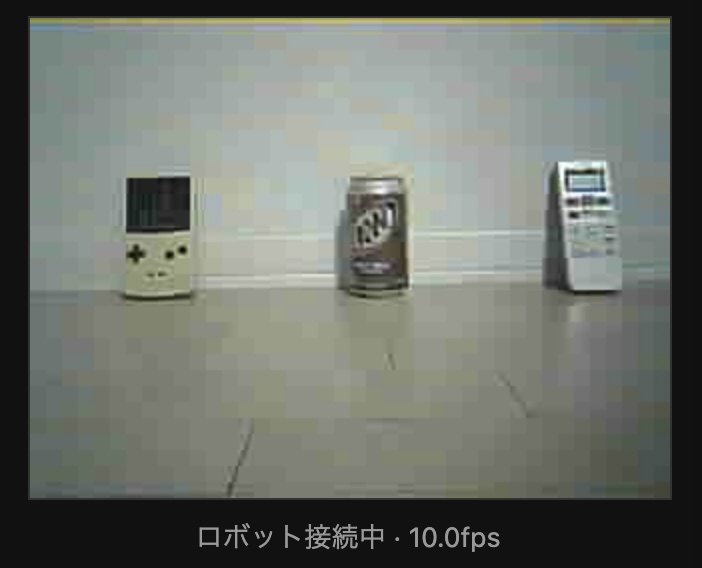
実行時のログを確認すると、機体はまず左右へ45度ずつ旋回して周囲の視界を広く取得しました。その後、初期の画角には収まっていなかった段ボールの裏側へ回り込み、そこに置かれていた別の缶コーヒーの銘柄を識別して報告を返してきました。
推論ログを確認すると、初期位置の視界に映っていた物体を識別したのち、段ボールの端に見切れていた未確認領域を解消するため、位置を変えて死角を確認するツールの呼び出しが順次行われていました。明示的な移動経路を人間が指示しなくても、プロンプトの指示に基づき探索行動に必要なツールが呼び出される様子を確認できました。
MCPでAIへ渡すもう一つの利点
MCPを用いたツール連携には、動作の自律化だけでなく、対話履歴を通じた文脈の保持が容易になる利点があります。単発のAPI呼び出しを繰り返す構成と異なり、直前の移動結果や試行のエラー情報をセッション内で引き継げるため、機体の挙動補正を動的に行いやすくなります。現状はClaudeを実行するPCとの通信を前提としていますが、将来的により高性能な小型シングルボードコンピュータを機体に直接搭載できれば、構成を一段と簡素化できる見込みです。
この先の発展
全3回を通して、「音声指示で動く自律走行ロボット」の基本動作を実現できました。
一方で、通信のオーバーヘッドに起因する反応遅延や、認識の精度面には改善の余地が多く残されています。今回は開発の容易さを優先して音声認識処理をCloudflare側に委譲しましたが、当初の構想どおり機体側のマイクだけで完結させる構成への改修も今後の課題です。
ハードウェアを組み上げる物理的な工作にとどまらず、搭載する推論モデルの違いによる走行パターンの変化を比較検証する試みにも広がりがあります。小型のエッジデバイス上でローカルLLMを動作させれば、外部ネットワークとの通信を省いて応答性を高められる可能性があります。ESP32やArduinoのGPIOピンに余裕があれば、ロボットアームを追加して物体を把持する機構への拡張も考えられます。
組み込み開発やロボット工学の専門教育を受けていなくても、生成AIを活用した設計補助やコード生成の支援を得ることで、ハードウェアと連携した自律システムを個人で形にできる環境が整いつつあります。
回路の短絡(ショート)や、データシートに記載された定格電圧・最大電流の確認といった電子工作の基本ルールを徹底し、安全に配慮しながら今後の改良を楽しんでいこうと思います。
mstmst37
Web Engineer / AI Engineer